

生成AIのガードレール – 有害な出力の判定技術New

はじめに
生成AIをサービスに組み込む際には、危険な回答や、許可されていない操作を防ぐ必要があります。暴力や犯罪の支援、属性に基づいて人や集団を攻撃するヘイトスピーチ、個人情報の漏えいなどが対策の対象です。
大量の文章から言葉の使い方を学習した大規模言語モデル(LLM)の入出力や動作を監視・制御する仕組みを「ガードレール」と呼びます。本記事では、ガードレールの全体像と有害性を判定する主な方法を解説します。
多層的な防御
ガードレールは、危険が生じる場所に応じて設けます。回答の出力だけでなく、入力や外部情報、ツールの操作にも対策を組み合わせるのが、多層的な防御です。図1に、入力から回答の表示までの流れと、外部文書やツールを利用する経路に検査を設けた構成例を示します[1]。検索やツールの利用は必要に応じて行うため、すべての処理が一直線に進むわけではありません。
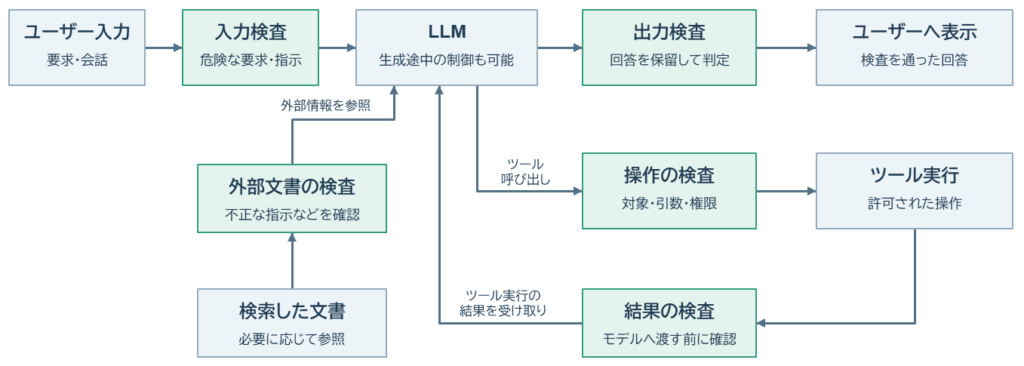
図1 入力・外部文書・ツール操作・出力を検査する多層的な防御の構成例(筆者作成)
まず、入力検査では、ユーザーの要求に危険な内容や安全機構の回避を狙う指示が含まれていないかを確認します。入力を検査してから、LLMへ渡します。
外部情報を参照する場合は、外部文書の検査を行います。文書を検索して回答に利用する仕組みは「検索拡張生成(RAG)」と呼ばれます。検索した文書に不正な指示が埋め込まれていると、回答や操作が誘導されるおそれがあるため、LLMに渡す前に確認します。
ツールを使って作業するAIエージェントでは、操作と結果の検査も必要です。回答の文章が無害でも、その前にツールで機密情報を外部送信していれば、出力検査だけでは防げません。このため、実行前に操作の対象と権限を確認し、返された結果もモデルへ渡す前に検査します。
生成モデルには、生成途中の制御を加える方法もあります。危険な回答の生成を抑えたり、途中で停止したりして、回答が完成する前に対処します。例えば、SafeDecoding[2]は、安全な回答につながるよう生成途中の選択を調整する手法です。
最後に、出力検査では、表示前の回答を一時保留し、入力や会話と合わせて判定します。結果に応じて表示・保留・遮断を決め、判断が難しい場合は人による確認に回します。再生成した回答も、検査してから表示します。
ガードレールの方式
利用時の検査では、図1の各段階で検出したい内容に応じて、判定方式を見ていきます。
ガードレールのうち、有害性を判定する技術は、主な判定の仕組みに着目すると、ルールベース・モデルベース・LLMベースに整理できます。表1では、Wangら[3]の分類に沿って、LLMに直接判断させる方式を独立した区分として示します。
表1 ガードレールの主な判定方式3
| 実装方式 | 判定の仕組み | 論文で挙げられる例 |
| ルールベース | キーワードや、文字列のパターンを指定する正規表現など、あらかじめ決めた条件で判定する | 正規表現による電話番号・メールアドレスなどの個人情報の検出 |
| モデルベース | 有害・無害などを推定する分類器や、統計量、モデル内部の特徴を使って判定する | 分類器のRandom Forestや文章の予測しにくさを表すパープレキシティの閾値、内部特徴の分析 |
| LLMベース | LLMに文章の有害性を分類させたり、危険性を推論させたりする | Llama Guard[4]、WildGuard[5]、GuardReasoner[6] |
LLMベースの判定では、LLMに評価者として採点させる「LLM-as-a-Judge」も使われます。その研究例として、KDDI総合研究所は、性格特性を6つの要素で捉える心理学のHEXACOモデルを応用しています。入力と回答から推測される特性を「正直さ・謙虚さ」などの観点で採点し、そのスコアを組み合わせて不適切な内容かどうかを判定します[7],[8]。
判定結果とスコア
有害性を判定するには、まず何を許容するかを定めた「安全ポリシー」が必要です。その基準を当てはめる際には、文脈も考慮します。犯罪の実行手順と被害を防ぐ説明では、同じ単語が含まれていても、文章が果たす役割は異なるためです。
有害性を判定する範囲には、単語などの小さな単位、入力や回答全体、会話履歴全体があります。一つの発言だけでは問題が見えなくても、会話の流れを含めると危険な要求だとわかる場合があります。
有害性の判定結果は、数値スコアとは限りません。ルールへの一致や、モデルが返す「安全・有害」などの分類結果で判断する場合もあります。数値スコアを使う場合には、判定を分ける境界値である「閾値」を設ける方法があります。高い値ほど有害とみなすスコアでは、閾値を下げると見逃しを減らしやすい反面、無害な回答も止めやすくなるため、用途に合わせた調整が必要です。
見逃しと過剰な遮断の評価
評価には、危険な事例と無害な事例の両方を使います。全体のうち正しく判定した割合である「正解率」だけでは、数の少ない有害な回答を見逃していても高い値になる場合があります。有害な回答をどれだけ検出できたかに加え、無害な回答をどれだけ誤って止めたかを調べます。
無害な要求まで拒否する「過剰拒否」が多ければ、使い勝手を損ないます。待ち時間や費用も含め、有害性を低めた効果と利用への影響を評価します。日本語で利用する場合は、実際の用途に近い言い回しや、危険な表現を引用した文章なども含めて検証します。
複数の判定器を組み合わせても、同じ事例を見逃す可能性があります。判定専用モデルとLLMの比較研究でも、誤判定の重なりが報告されています[9]。 対策を増やしたことだけで安心せず、組合せの効果を確認し、モデルやポリシーの更新後も再評価するのがポイントです。
5. まとめ
ガードレールでは、守る対象と安全ポリシーを定め、危険が生じる場所に検査や制御を組み込みます。判定方式と判定する範囲を用途に合わせて選び、分類結果やスコアを、回答の表示・保留・遮断を決める材料として使います。
導入後も、有害な回答や操作を防げるかと、無害な利用を妨げていないかを併せて確認します。複数の対策を組み合わせ、その効果を継続して確かめることが必要です。
[1] NVIDIA, “Guardrail Types,” NeMo Guardrails Library Developer Guide, 2026-10-07確認. https://docs.nvidia.com/nemo/guardrails/latest/about-nemo-guardrails-library/rail-types
[2] Z. Xu et al., “SafeDecoding: Defending against Jailbreak Attacks via Safety-Aware Decoding,” ACL 2024, pp. 5587–5605. https://aclanthology.org/2024.acl-long.303/
[3] X. Wang et al., “SoK: Evaluating Jailbreak Guardrails for Large Language Models,” IEEE S&P 2026. https://arxiv.org/abs/2506.10597
[4] H. Inan et al., “Llama Guard: LLM-based Input-Output Safeguard for Human-AI Conversations,” arXiv:2312.06674, 2023. https://arxiv.org/abs/2312.06674
[5] S. Han et al., “WildGuard: Open One-Stop Moderation Tools for Safety Risks, Jailbreaks, and Refusals of LLMs,” NeurIPS 2024. https://arxiv.org/abs/2406.18495
[6] Y. Liu et al., “GuardReasoner: Towards Reasoning-based LLM Safeguards,” arXiv:2501.18492, 2025. https://arxiv.org/abs/2501.18492
[7] 長谷川ら,「会話文から推測されるパーソナリティ指標を利用した不適切な文章の検知」, SCIS 2026. KDDI Tech note, 「生成AIを安全に利活用するための高精度なガードレール技術」, 2026-04-08. 開発元解説
[8] KDDI Tech note, 「生成AIを安全に利活用するための高精度なガードレール技術」. https://tech-note.kddi.com/n/n568507230461
[9] D. Rao et al., “JEV vs. LLMs as Rubric Judges: Cheaper, Faster, and Wrong in the Same Places,” arXiv:2609.29769, 2026. https://arxiv.org/abs/2609.29769