

AIの言い訳をハックする?XAI(説明可能なAI)に対する攻撃New

はじめに
生成AIの利用に当たり、AIの推論出力が必ずしも正しいとは限らないことを念頭に置いてダブルチェックなどを行うことが推奨されていますが、その半面、AIモデルが複雑化するにつれ、なぜAIがその判断や予測をしたのかの根拠を、利用者が理解すること自体が難しくなってきています。
XAI(説明可能なAI)は、この問題を解決するために考案された概念であり、生成AIの推論出力と一緒に、その判断・予測根拠を図解や文面などで提示する技術として実用化されています。しかし一方で、そのXAIの仕組みを逆手に取ったサイバー攻撃により、悪意ある推論出力に、いかにも尤もらしい説明を付加させて正当なものに見せかけ、利用者を誤信に招けることが明らかになっています。本記事ではこのような「説明可能性に対する攻撃」について解説します。
敵対的XAIによる攻撃手法
XAIを悪用して利用者を騙す攻撃手法には、広く敵対的XAI(Adversarial XAI)に分類されるものの他に、偽XAIを用いたソーシャルエンジニアリングなどもありますが、ここでは、XAIそのものに対する操作を行う技術である、前者の敵対的XAIに焦点を絞ることとします。
攻撃手法の前提となる、XAIの機能構成は、現時点では、通常のAIモデル(XAIに特化した機能などを持たないもの)の外側に、説明生成器を配置したものが、主流となっています。説明生成器は、AIモデルの入力データと推論出力とを比較して、根拠説明を生成します(図 1の左側)。
上記のような構成のXAIを標的とした、敵対的XAIによる攻撃では、攻撃者は正当な入力データを基に、悪意ある入力データを調製します。それを用いて、AIモデルには誤った判断や予測をさせた上で、説明生成器にはさも正当であるかのような根拠説明を出力させることを狙います(図 1の右側)。なお、敵対的XAIは本来、XAIの説明可能性に関する脆弱性を探るための技術であり、攻撃だけでなく、その結果に基づくセキュリティ強化にも活用されます。
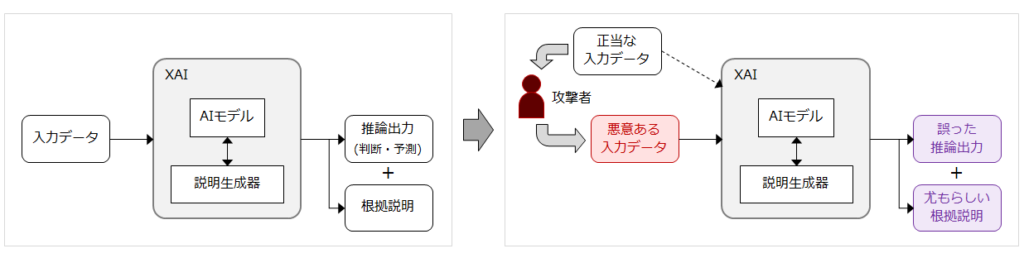
図 1 XAIの代表的な機能構成例(左)と、敵対的XAIによる攻撃例(右)
敵対的XAIによる攻撃の仕組みは学術研究の途上にあり、2010年代終盤以来、さまざまな手法が提案されています。標的となるXAIに対する、攻撃者の権限に応じて、攻撃手法が異なります。
攻撃者が強い権限を持つことを前提とした攻撃手法の例として、2020年に公開された論文[1]では、XAIの良く知られた実現方式であるLIME[2]およびSHAP[3]を対象とした、Scaffolding(「足場」の意味)と称する仕組みが提案されています。攻撃者は、標的であるXAIの制御機構を直接操作して、次のように2段階の攻撃を実行します。まず、AIモデルが推論を実行する段階では、攻撃者が用意した悪意あるデータを入力して、誤った推論出力を行わせます。次に、説明生成器が入力データを少しずつ変えながらAIモデルの反応変化を観測する段階では、逆に無害なデータを渡すことで、正当な内容を出力させ、それを基に説明生成器が正当な説明を付加するよう仕向けます。
それとは対照的な手法の研究として、2023年のXAIFooler[4]では、攻撃者の権限がより弱い場合における、攻撃の仕組みが提案されています。ここでは攻撃者は、LIMEの説明生成器の特徴量重要度スコアを取得または算出できるものとします。攻撃者は、正常な入力データに含まれる単語のうち、重要度があまり高くないものを変化させて(つまり文意ができるだけ保たれるようにして)、悪意ある入力データを導出します。これを繰り返しながら、AIモデルが出力する予測ラベルは変化させないまま、説明生成器が出力する説明データの基になる、特徴量重要度スコアの順位変更を引き起こせたかどうかを検査します。
実際の攻撃の難しさと攻撃シナリオ例
現実世界での攻撃の標的として、企業などの組織内で運用されているXAIや、インターネット上のサービスとして提供されているXAIを考えると、攻撃者にとって、いくつかハードルが加わります。
まず、稼働しているXAIの種類や、その中で動作するAIモデルの種類、パラメータ設定などの諸元が、必ずしも明らかでないことが挙げられます。特に、組織内のXAIでは、こうした情報が公開されることは稀であると考えられます。敵対的XAIに頼った攻撃手段を取るということは、標的のXAIが運用されているシステムへのサイバー侵入が叶わなかった前提となるため、攻撃者は具体的な諸元情報を入手できず、代表的なXAI・代表的なAIモデルを仮定して、いわゆる「山を張る」形で攻撃試行することになります。
次に、XAIの利用者は、当然ながら、攻撃者とは別にいることが挙げられます。利用者が人間である場合には、攻撃者はその利用者がXAIへのデータ入力操作を行ったタイミングでそれを横取りして、その内容を基に悪意あるデータを生成し、そちらをXAIに入力する、という介入動作が必要になりますが、これは予め利用者のPCなどへのサイバー侵入に成功していることが前提となります。それが難しい場合には、別の標的として、攻撃者が送り込んだ悪意あるデータが、そのままXAIへ自動入力されるようなシステムを選定することになります。例えば以下のような攻撃シナリオが想定されます。
- マルウェア検知機構のすり抜け
組織内ネットワークに設置されたIDS(不正侵入検知システム)の裏側で、XAIを用いた高度なマルウェア検知の仕組みが稼働しているとします。攻撃者は、敵対的XAIを用いて検知機構を欺くよう調製したマルウェアを、例えば電子メールに添付するか、あるいはウェブサーバに仕込んでおいてアクセスを受けた時点で返送するといった方法で、その組織へ送り付けます。この攻撃が成立した場合、検知XAIの出力は、「マルウェアではない」との誤判定に、尤もらしい根拠を付記したものになり、その結果として、アラート対象から外れたり、出力内容を目にしたセキュリティ運用者が疑いを持つに至らなかったりして、少なくともその時点でのマルウェア検知を逃れる可能性があります。
- 金融取引における与信操作
クレジットカード決済などの金融取引におけるシステム構成の仮定として、与信リスク分析を行うXAIと、最終的な取引承認判断を行うXAIとが連携動作する、マルチエージェント構成になっている場合を考えます。分析XAIへの入力データには、利用者の新規取引要求に加えて、過去の取引履歴なども含まれます。また、それらのデータに基づくリスク分析結果が、根拠説明(人間でなく、XAIに理解させるためのもの)を添えた形で、後段の承認XAIへ入力されます。ある利用者が、取引トラブルなどが原因で信用度が下がっており、この状況を手早く(つまり不正に)改善しようと考えます。過去の取引履歴は変えられませんが、現在以降の取引パターンを、承認が下りる金額の範囲内で工夫することで、分析XAIを騙して、信用度を上げられないでしょうか。敵対的XAIを用いれば、それが可能になるような、悪意ある取引パターンを見つけられるかも知れません。この攻撃が成立した場合、分析XAIは、その後の新規取引要求に対して、与信リスクが「十分に低い」との誤った判定をした上で、尤もらしい根拠説明を付けて、後段の承認XAIへ渡します。その他の判断要素もクリアされていれば、取引要求が承認されます。ただし、一般の利用者にとって、分析XAIを含むシステム全体がブラックボックスになっているため、この攻撃の実行には困難を伴うものと考えられます。
防御技術
敵対的XAIによる実際の攻撃が特定された事例は、現時点ではまだ見られませんが、これは攻撃技術が進化途上であることの他に、攻撃を受けた側がそれと認知できず見逃した可能性も考えられます。そのため、攻撃の検知や予防を行える技術の、早期成熟が望まれます。
最近の学術研究では、敵対的XAIによる攻撃を防御する手法がいくつか提案されています。2025年に公開されたSHLIME[5]では、動作特性の異なる複数のXAI(具体的にはLIMEとSHAP)を同時動作させ、それらの説明出力を組み合わせることで、敵対的XAIによる攻撃の影響を受けにくくします。また、2026年のExplainability-Guided Defense[6]では、敵対的学習の一環として、LIMEを用いてAIモデルの分析を行い、推論への寄与度は高いが本質的ではない(従って攻撃対象になりやすい)特徴量を隠蔽するなど、複数処理の併用により、モデル自体の攻撃耐性を高める手法が提案されています。
特定分野における予防的対策手法も研究されています。2026年に公開された論文[7]では、P2Pレンディング(インターネット上で資金を借りたい人と貸したい人(投資家など)とを直接仲介するサービス)の、与信リスク分析を担うAIモデルを誤判断へと誘導する攻撃に対抗するため、敵対的学習と、XAI(具体的にはSHAP)を用いたAIモデル切り替え機構との併用により、攻撃耐性を向上させる仕組みが提案されています。
おわりに
本記事では、XAIの利用者を騙す攻撃手法のひとつである、敵対的XAIを用いた攻撃について解説しました。XAIの導入が広がる中、そうした攻撃に対する最新の防御技術をいち早く取り入れ、攻撃技術の今後の進化に対して先手を打つ対応を、継続的に行うことが推奨されます。
[1] Dylan Slack, Sophie Hilgard, Emily Jia, Sameer Singh, and Himabindu Lakkaraju, “Fooling LIME and SHAP: Adversarial Attacks on Post hoc Explanation Methods”, 3 Feb. 2020, https://arxiv.org/abs/1911.02508 .
[2] Marco Tulio Ribeiro, Sameer Singh, and Carlos Guestrin, “ “Why Should I Trust You?”: Explaining the Predictions of Any Classifier”, 9 Aug. 2016, https://arxiv.org/abs/1602.04938 .
[3] Scott M. Lundberg and Su-In Lee, “A Unified Approach to Interpreting Model Predictions”, 25 Nov. 2017, https://arxiv.org/abs/1705.07874 .
[4] Christopher Burger, Lingwei Chen, and Thai Le. 2023. “ “Are Your Explanations Reliable?” Investigating the Stability of LIME in Explaining Text Classifiers by Marrying XAI and Adversarial Attack”, The 2023 Conference on Empirical Methods in Natural Language Processing (EMNLP 2023), https://aclanthology.org/2023.emnlp-main.792/ .
[5] Sam Chauhan, Estelle Duguet, Karthik Ramakrishnan, Hugh Van Deventer, Jack Kruger, and Ranjan Subbaraman, “SHLIME: Foiling adversarial attacks fooling SHAP and LIME”, 14 Aug. 2025, https://arxiv.org/abs/2508.11053 .
[6] Longwei Wang, Mohammad Navid Nayyem, Abdullah Al Rakin, KC Santosh, Chaowei Zhang, and Yang Zhou, “Explainability-Guided Defense: Attribution-Aware Model Refinement Against Adversarial Data Attacks”, 2 Jan. 2026, https://arxiv.org/abs/2601.00968 .
[7] Justus V. D. Straus, Valeri K. Andreev, Tijn Koeleman, Thomas Sepanosian, and Marcos R. Machado, “Explaining to defend: SHAP-based defense mechanism against adversarial attacks in P2P credit risk”, Expert Systems With Applications 301 (2026) 130432, https://www.sciencedirect.com/science/article/pii/S0957417425040473 .